
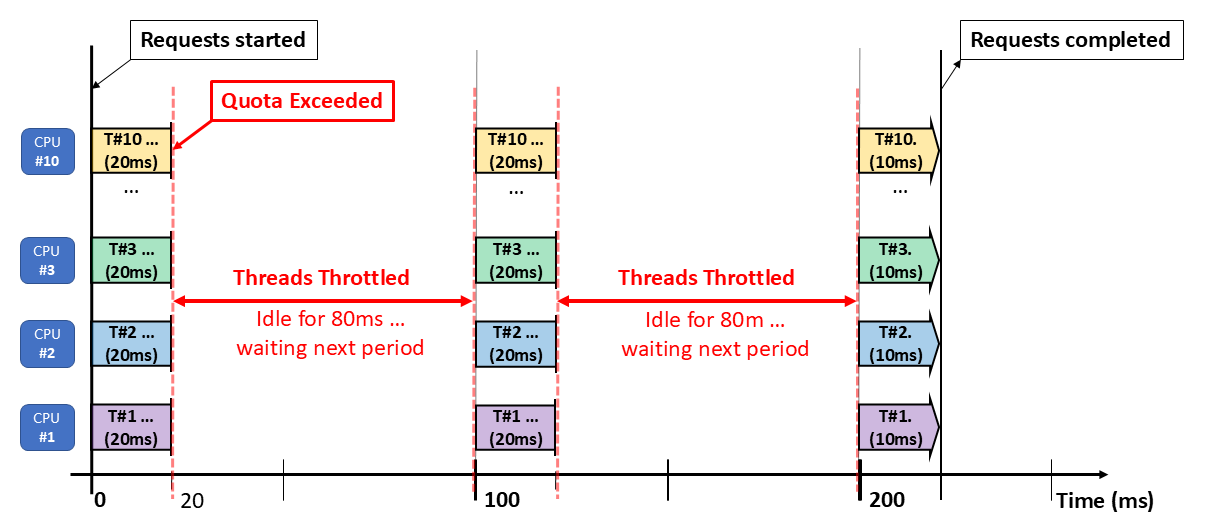
一、 核心困惑:为什么 CPU 使用率很低,却触发了节流告警?
在 Kubernetes 的日常运维中,一个非常普遍且令人困惑的现象是:监控仪表盘显示容器的 CPU 平均使用率 非常低,但同时却收到了严重的 CPU 节流 告警。
这引出了一个核心问题:CPU 节流告警的触发,并非取决于长时间的 平均 CPU 使用率,而是由毫秒级别的 瞬时 CPU 峰值 撞上资源限制(
limits.cpu)所导致的。平均值会掩盖这些对应用性能造成致命影响的瞬时瓶颈。
二、 CPU 节流的根本原理:CFS Quota
Kubernetes 的 CPU 限制(limits)依赖于 Linux 内核的 CFS (Completely Fair Scheduler) Quota 机制。理解其工作方式是解开谜团的关键。
- 调度周期 (
cpu.cfs_period_us): CFS 将时间划分为一个个微小的调度周期,通常固定为 100ms(即 100,000 微秒)。 - CPU 配额 (
cpu.cfs_quota_us): 它定义了在一个调度周期(100ms)内,一个容器被允许使用的 CPU 总时间。这个值由limits.cpu决定。limits.cpu: "1"意味着配额为 100ms。limits.cpu: "0.5"(或500m) 意味着配额为 50ms。limits.cpu: "2"意味着配额为 200ms。
节流的触发机制: 在一个 100ms 的时间窗口内,如果容器用满了其全部分配的 CPU 配额(例如 50ms),那么在这个周期的剩余时间里(剩下的 50ms),内核会强制暂停该容器的进程,不允许其再被调度执行。这个强制暂停就是“节流”(Throttling)。直到下一个 100ms 周期开始,容器才能重新获得 CPU 时间。
生动的比喻:高速公路的平均速度与瞬时超速
| 概念 | 类比 | 解释 |
|---|---|---|
| 平均 CPU 使用率 | 一小时内的 平均车速 | 您可能开了10分钟(时速150km/h),然后停车了50分钟,最终平均时速仅为25km/h,远低于限速。 |
| CPU 节流 | 瞬时超速被 摄像头抓拍 | 在那飞驰的10分钟里,您的瞬时速度超过了120km/h的限制,因此被判定为违规。 |
结论:应用的平均 CPU 使用率低,完全不代表它在处理请求的关键路径上没有发生严重的、损害性能的瞬时节流。
三、 如何正确监控与告警
鉴于平均使用率的“欺骗性”,我们必须使用正确的指标来监控和告警。
1. 黄金指标:periods 而非 seconds
cAdvisor 提供了两个相关的节流指标,但它们的可靠性天差地别:
| 指标 (Metric) | 含义 | 可靠性与可用性 | 推荐度 |
|---|---|---|---|
container_cpu_cfs_throttled_periods_total |
容器被节流的 周期总数 | 高。这是最标准、最可靠的节流指标,几乎所有环境都提供。 | ⭐⭐⭐⭐⭐ |
container_cpu_cfs_throttled_seconds_total |
容器被节流的 累计总时长 | 低。严重依赖内核版本,在很多系统中恒为0,导致查询无数据。 | ⭐ |
实践准则:始终使用 container_cpu_cfs_throttled_periods_total 和 container_cpu_cfs_periods_total 来进行计算。
2. 标准告警规则:CPUThrottlingHigh
这是一个业界标准的告警规则,用于检测节流率是否超过了某个阈值(例如 25%)。
sum without (id, metrics_path, name, image, endpoint, job, node) (
  topk by (cluster, namespace, pod, container, instance) (1,
    increase(container_cpu_cfs_throttled_periods_total{container!="",job="kubelet",metrics_path="/metrics/cadvisor"}[5m])
  )
)
/ on (cluster, namespace, pod, container, instance) group_left ()
sum without (id, metrics_path, name, image, endpoint, job, node) (
  topk by (cluster, namespace, pod, container, instance) (1,
    increase(container_cpu_cfs_periods_total{job="kubelet",metrics_path="/metrics/cadvisor"}[5m])
  )
)
> (25 / 100)- 核心逻辑:
(过去5分钟节流周期增量) / (过去5分钟总周期增量) > 0.25 - 含义: 如果一个容器在5分钟内,有超过25%的调度周期都发生了节流,则触发告警。这是一个非常明确的性能问题信号。
3. 仪表盘可视化查询
为了在 Grafana 等工具中可视化 CPU 节流的严重程度,应使用与告警规则类似的逻辑,计算节流率。
# 计算 CPU 节流率 (%)
sum(rate(container_cpu_cfs_throttled_periods_total{namespace="$namespace", pod=~"$pod", container!=""}[$__rate_interval])) by (pod, container)
/
sum(rate(container_cpu_cfs_periods_total{namespace="$namespace", pod=~"$pod", container!=""}[$__rate_interval])) by (pod, container)
* 100
将这个查询的结果以百分比的形式展示在图表上,可以非常直观地定位到哪些 Pod 或容器正在遭受 CPU 节流的影响。
四、 解决方案与实践
当确认发生 CPU 节流后,可以根据业务场景和资源情况选择以下一种或多种方案。
1. 调整 CPU limits(最直接)
这是最快、最直接的解决方法。如果应用确实存在无法优化的瞬时 CPU 峰值,适当地提高 limits.cpu 的值可以立竿见影地减少节流,改善应用响应时间。
- 操作:
kubectl edit deployment/...修改容器的resources.limits.cpu值。 - 建议:可以尝试将
limits翻倍,然后持续观察节流率是否显著下降。
2. 仅设置 requests,移除 limits(需谨慎)
当容器只设置 requests 而不设置 limits 时,其 QoS 等级为 Burstable。
- 优点:
- 消除节流:只要节点上存在空闲的 CPU 资源,容器就可以突破
requests的限制尽情使用,从而完全避免了 CFS 节流带来的性能惩罚。 - 提高资源利用率:充分利用节点的闲置资源。
- 消除节流:只要节点上存在空闲的 CPU 资源,容器就可以突破
- 缺点:
- “吵闹的邻居”:一个行为异常的容器可能会耗尽整个节点的 CPU,影响同一节点上其他服务的稳定性。
- 资源规划困难:由于容器使用资源的行为不可预测,给集群的容量规划带来挑战。
- 适用场景:对延迟非常敏感、能容忍资源争抢的服务,或在资源隔离做得很好的非生产环境中。
3. 优化应用程序代码(最根本)
从根源上解决问题。通过性能分析工具(如 Profiler)定位到导致 CPU 峰值的代码逻辑。
- 方向:
- 优化算法,减少计算复杂度。
- 将同步的、CPU 密集型的单线程任务改造为异步或多线程的平缓处理模式。
- 引入缓存,减少重复计算。
4. 使用静态 CPU 管理策略(终极方案)
对于需要极致性能和稳定低延迟的数据库、消息队列等应用,可以启用节点的 静态 CPU 管理策略 (static policy)。
- 要求:容器必须为
GuaranteedQoS 等级(requests和limits相等且为整数)。 - 效果:Kubernetes 会为该容器分配独占的物理 CPU 核心。进程将完全脱离 CFS Quota 的管制,不再有任何节流,并且可以避免与其他进程争抢核心所带来的上下文切换开销。
- 代价:会降低节点的 CPU 资源利用率,因为被分配的核心无法被其他任何容器共享。
留言